Szybka odpowiedź: jak przygotować stronę pod Przeglądanie Agentowe w PageSpeed Insights?
- Zacznij od fundamentów frontendu, czyli semantycznego HTML, czytelnych nazw i ról w drzewie dostępności oraz stabilnego układu z niskim CLS.
- Kluczowe treści nie mogą pojawiać się dopiero po wykonaniu JavaScriptu.
- Plik
llms.txti WebMCP są na razie opcjonalne, a WebMCP ma sens głównie tam, gdzie agent wykonuje akcję, np. wysyła formularz. - Wynik kategorii Przeglądanie Agentowe nie jest czynnikiem rankingowym i nie mierzy cytowań ani ruchu z asystentów AI.
Przeglądanie Agentowe to eksperymentalna kategoria audytów w Lighthouse, która sprawdza, czy strona jest czytelna i nawigowalna dla agentów AI. Pojawia się w raportach PageSpeed Insights obok znanych kategorii jak Wydajność czy Ułatwienia dostępu, ale działa inaczej. Zamiast jednego wyniku punktowego dostarcza zestaw audytów zaliczonych, niezaliczonych i informacyjnych oraz proporcję zaliczonych kontroli.
Jest to o tyle istotne, że Lighthouse zaczyna diagnozować, czy strona jest wystarczająco czytelna, stabilna i opisana, żeby agent AI mógł się po niej poruszać bez zgadywania. Nie jest to jednak oficjalny czynnik rankingowy Google ani miara cytowalności w odpowiedziach AI. To deterministyczny audyt techniczny, który pomaga wykryć problemy z interakcją i strukturą strony.
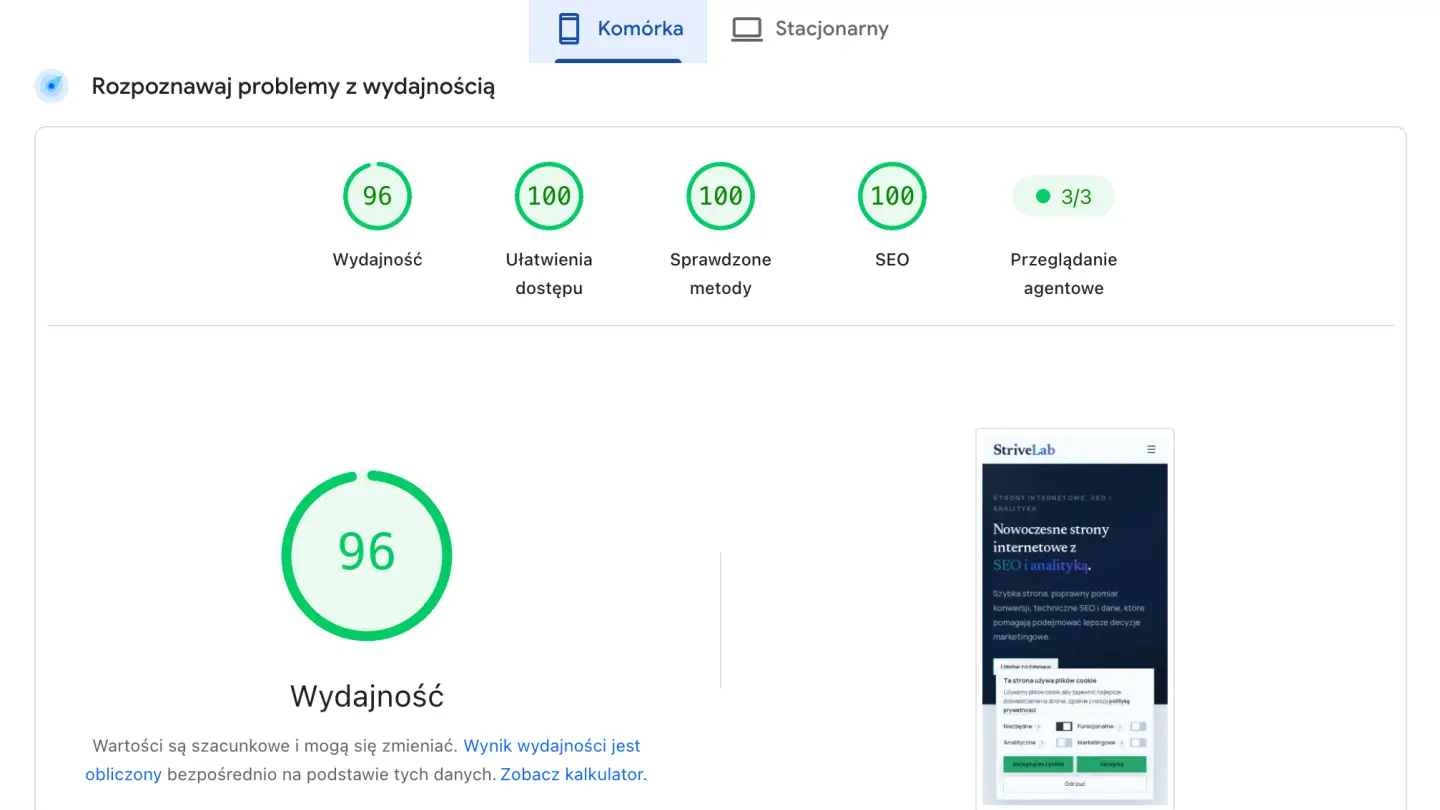
Raport dla StriveLab w PageSpeed Insights z widoczną kategorią Przeglądanie Agentowe.
Dlaczego strony projektowane tylko pod warstwę wizualną są trudne dla agentów AI
Strona może wyglądać świetnie dla widzącego użytkownika posługującego się myszą, ale może być jednocześnie chaosem dla poruszającego się po niej agenta AI oraz dla osób korzystających z technologii asystujących. Dostępność jest przede wszystkim dla ludzi, a część jej fundamentów pomaga również agentom. Problemy powodują między innymi menu renderowane dopiero po hydratacji, przyciski zrobione z div, formularz bez etykiet, hero przesuwające layout po załadowaniu fontu albo treść schowana za klientowym JavaScriptem.
Użytkownik może tego nie zauważyć podczas korzystania ze strony, ale dla agenta AI oznacza to utratę kontekstu. Agenty przeglądarkowe mogą korzystać z drzewa dostępności, DOM-u, tekstu i zrzutów ekranu. Jeśli te warstwy nie przekazują spójnych informacji, agent może źle rozpoznać ofertę albo kliknąć niewłaściwy element. Taki problem utrudnia wykonanie zadania na stronie, ale sam w sobie nie dowodzi, że witryna zostanie pominięta w odpowiedziach AI.
Warto rozdzielić dwa etapy. Wyszukiwanie i wybór strony nadal opierają się na zasadach SEO oraz mechanizmach konkretnego dostawcy. Przeglądanie Agentowe dotyczy późniejszego etapu, w którym agent otwiera witrynę, interpretuje interfejs i próbuje wykonać zadanie.
Co bada Przeglądanie Agentowe w Lighthouse i PageSpeed Insights?
W praktyce można opisać gotowość strony za pomocą dwóch pojęć: i . To pomocniczy sposób interpretacji wyniku, a nie dwa oficjalne wymiary punktacji Lighthouse.
Wykrywalność oznacza, czy agent potrafi odkryć, co jest na stronie ważne. Czy widzi główną treść? Czy linki prowadzą do kluczowych sekcji? Czy llms.txt podpowiada, gdzie szukać najważniejszych informacji? Czy formularz kontaktowy ma etykiety, a przycisk mówi programowo, co robi?
Nawigowalność oznacza, czy agent potrafi po tej stronie bezpiecznie przejść i nie zgubić kontekstu. Istotnych jest w tym procesie kilka rzeczy. Czy layout nie przesuwa się pod kursorem? Czy element interaktywny jest realnym <button> albo <a>, a nie dekoracyjnym kontenerem z onClick? Czy menu, formularze i karty są obecne w DOM-ie w przewidywalny sposób?
Aktualna konfiguracja kategorii obejmuje drzewo dostępności, CLS, trzy kontrole WebMCP oraz audyt llms.txt:
. Agent korzysta z nazw, ról i relacji elementów. Jeśli ikona-przycisk nie ma etykiety, człowiek może się domyślić po wyglądzie, ale agent dostaje pustą informację.
, czyli Cumulative Layout Shift, opisuje stabilność układu. Jeśli element zmienia pozycję między identyfikacją a kliknięciem, agent może trafić w nieprawidłowe miejsce.
llms.txtjest opcjonalną konwencją, a sam audyt sprawdza plik w katalogu głównym domeny. Lighthouse sprawdza jego dostępność i podstawową strukturę, ale odpowiedź 404 równoznaczna jest z wynikiem „nie dotyczy” (N/A), a nie z błędem.obejmuje listę zarejestrowanych narzędzi, formularze bez deklaratywnych metadanych i poprawność schematu. Część tych wyników ma obecnie charakter informacyjny.
Jak przełożyć wynik audytu na poprawkę?
Poniższe przykłady pokazują sposób interpretacji kontroli, a nie wyniki nowego pomiaru StriveLab. Konkretne nazwy i zakres audytów sprawdzaj w swojej wersji raportu.
| Wynik lub sygnał | Co sprawdzić | Poprawka i ponowny test |
|---|---|---|
| Element interaktywny bez nazwy | Czy przycisk ma nazwę w drzewie dostępności? | Dodaj tekst lub odpowiednią etykietę, następnie sprawdź drzewo i ponów audyt. |
| Problem z rolą lub relacją elementów | Czy struktura komponentu odpowiada jego funkcji? | Zacznij od natywnego HTML; po poprawce sprawdź również otwarty i zamknięty stan komponentu. |
| Przesunięcia układu | Który element zmienia położenie i kiedy? | Zarezerwuj miejsce na dynamiczną treść; powtórz pomiar i interakcję, podczas której występował problem. |
llms.txt: „nie dotyczy” przy 404 | Czy plik jest potrzebny w Twoim scenariuszu? | Brak pliku nie wymaga naprawy. Jeśli go publikujesz, sprawdź odpowiedź HTTP i format. |
| Formularz bez metadanych WebMCP — informacja | Czy ma być udostępniony jako narzędzie? | Nie dodawaj API wyłącznie dla wyniku. Jeśli ma zastosowanie, opisz formularz i przetestuj wywołanie. |
| Błąd schematu WebMCP | Którego pola lub opisu dotyczy komunikat? | Popraw wskazaną definicję, ponów kontrolę i osobno sprawdź wykonanie narzędzia. |
Lista kontrolna techniczna: jak przygotować stronę pod Przeglądanie Agentowe
Pierwszym krokiem powinno być zrobienie porządku w rzeczach, które od lat są podstawą dobrego frontendu, dostępności oraz technicznego SEO.
Semantyczny HTML i struktura DOM dla agentów AI
Agent AI czyta strukturę strony, dlatego potrzebujemy klasycznego, semantycznego HTML:
- Używaj
<main>,<nav>,<article>,<section>,<aside>zgodnie z przeznaczeniem - Buduj interakcje na
<button>i<a href>, nie na klikalnychdiv-ach - Każdy element interaktywny musi mieć programową nazwę: tekst,
aria-labelalbo poprawnie powiązany<label> - Trzymaj logiczną hierarchię nagłówków i opisowe teksty linków
- Nie ukrywaj kluczowej treści za pomocą
aria-hidden, karuzeli bez wersji zapasowej ani komponentów istniejących dopiero po hydratacji
W React najczęstszy problem jest z komponentami współdzielonymi, czyli jeden nieprawidłowo napisany IconButton, CardLink albo niestandardowy Select potrafi masowo zepsuć dostępność np. na kilkunastu podstronach naraz.
Przykład przed i po: przycisk otwierający menu.
Obsługa kliknięcia musi aktualizować atrybut aria-expanded oraz widoczność menu. W panelu DevTools sprawdź, czy przycisk zyskał etykietę „Menu główne”, a jego stan ulega modyfikacji po otwarciu. Pamiętaj, aby przetestować również działanie z klawiatury oraz zarządzanie fokusem. Analogiczny model kontroli należy wdrożyć dla okna modalnego oraz formularza – system sztucznej inteligencji potrzebuje nie tylko nazwy pola, ale także czytelnego komunikatu o błędzie, informacji o stanie ładowania oraz potwierdzenia powodzenia operacji.
Plik llms.txt jako mapa strony dla agentów AI
llms.txt nie jest nowym robots.txt, który komunikuje reguły dostępu robotów indeksujących. Jest rozwijającą się, opcjonalną konwencją mającą dostarczać obsługującym ją narzędziom skrócony przewodnik po stronie. Nie ma jednak publicznej gwarancji, że dany agent pobierze ten plik. Google Search wyraźnie informuje, że go ignoruje. Szczegółowy format, przykłady dla Next.js i Astro oraz zasady utrzymania opisałem w osobnym poradniku o wdrożeniu pliku llms.txt.
Propozycja formatu wymaga tylko nagłówka H1. Krótki opis w blockquote i sekcje H2 z listami linków są opcjonalne, ale tworzą użyteczny, zalecany kształt dokumentu. Dla małej strony możesz zacząć od statycznego pliku, natomiast w blogu albo serwisie z CMS lepiej generować go z tego samego źródła prawdy co mapę witryny. Jeśli mapę witryny tworzysz automatycznie, a llms.txt aktualizujesz ręcznie, oba pliki szybko się rozjadą.
W zaktualizowanej 10 sierpnia 2026 r. propozycji standardu llms.txt v2 plik może znajdować się również w podścieżce – na przykład pod adresem /docs/llms.txt – i dotyczyć materiałów zgromadzonych poniżej tego katalogu. Dodatkowe powiązania, takie jak relacje linków alternate z typem text/markdown czy describedby, ułatwiają precyzyjne wskazanie wersji w formacie Markdown oraz właściwej lokalizacji pliku llms.txt. Są to rozwiązania opcjonalne przewidziane w ramach nowej specyfikacji, podczas gdy oficjalna dokumentacja audytu Lighthouse w dalszym ciągu zaleca weryfikację obecności pliku bezpośrednio w głównym katalogu serwisu.
Przykład minimalnego kształtu:
Jeśli decydujesz się na llms.txt, nie wrzucaj do niego wszystkiego jak leci. Linkuj strony kanoniczne, publiczne, aktualne i warte umieszczenia w skróconym kontekście. Pełne przykłady endpointów, filtrowanie draft/noindex, llms-full.txt i różnice między Astro a Next.js zostawiam w poradniku wdrożeniowym.
Jak poprawnie serwować llms.txt
Kompresja i cache ograniczają transfer oraz liczbę ponownych pobrań llms.txt, ale sam plik nie obniża Core Web Vitals strony, jeśli nie jest częścią jej procesu ładowania. Lighthouse pobiera go osobno na potrzeby audytu Przeglądania Agentowego.
W Next.js najprostszy wariant statyczny polega na zapisaniu pliku jako public/llms.txt i ustawieniu nagłówków w next.config.mjs:
max-age określa czas świeżości w przeglądarce, a s-maxage dotyczy współdzielonego cache CDN. Dłuższa wartość może opóźnić widoczność zmian, jeżeli hosting nie unieważnia cache po wdrożeniu. Przy generowaniu pliku przez Route Handler ustaw te same nagłówki bezpośrednio w zwracanym obiekcie Response.
Obsługę kompresji sprawdź na produkcji przez curl -I --compressed https://example.com/llms.txt. Nie zakładaj jej wyłącznie na podstawie konfiguracji frameworka, ponieważ ostateczne zachowanie zależy również od hostingu i CDN.
JavaScript, SSR i hydratacja: jak ograniczyć szum dla agentów AI
Część agentów i robotów indeksujących ma problem ze stronami, które bez JavaScriptu zwracają pusty dokument, a po hydratacji są niestabilne wizualnie. Dlatego treść i podstawowa nawigacja nie powinny niepotrzebnie zależeć wyłącznie od środowiska uruchomieniowego po stronie klienta. SSR, SSG i Server Components są tutaj rekomendacjami architektonicznymi.
- SSR/SSG dla treści, która ma być odkrywalna.
- Server Components tam, gdzie nie ma realnej interakcji.
- Małe Client Components zamiast całych sekcji oznaczonych
"use client". - Brak lazy-loadu dla kluczowej treści tekstowej.
- Rezerwacja miejsca na obrazy, osadzone elementy, banery cookies i dynamiczne bloki.
- Ograniczenie skryptów zewnętrznych, które opóźniają interakcję i zmieniają layout.
Obecność dyrektywy "use client" w Next.js wcale nie oznacza rezygnacji z generowania kodu HTML po stronie serwera. Komponenty klienckie biorą aktywny udział we wstępnym renderowaniu, a proces hydratacji nadaje im pełną interaktywność. Warto zatem weryfikować niezależnie strukturę pierwszej odpowiedzi oraz moment, w którym przyciski zaczynają reagować na działania użytkownika. Podobny mechanizm występuje w architekturze Astro, w której statyczny kod HTML jest oddzielony od interaktywnych wysp – dzięki temu zawartość strony, taka jak oferta czy łącza, pozostaje dostępna natychmiastowo, nawet jeśli skrypty poszczególnych wysp ładują się z opóźnieniem.
Najgorszy wariant to strona, która po pobraniu HTML-a pokazuje tylko pusty kontener aplikacji, a właściwa oferta, menu i CTA pojawiają się dopiero po hydratacji. Dla użytkownika na szybkim laptopie to może być niezauważalne. Dla części agentów i prostych robotów indeksujących to nadal pusta strona.
WebMCP w Przeglądaniu Agentowym: kiedy ma sens, a kiedy jest za wcześnie
jest ważny, ale trzeba go opisać precyzyjnie. To nie jest to samo co klasyczny używany przez Cursor, Claude Desktop czy własne integracje z CMS-em. O tym drugim piszę osobno w artykule o Model Context Protocol w TypeScript.
W kontekście Lighthouse WebMCP dotyczy strony w przeglądarce: formularzy, akcji i narzędzi, które agent mógłby rozpoznać bez zgadywania po wyglądzie. Przykładowo, może to być formularz kontaktowy opisany tak, żeby agent wiedział, jakie dane wpisać i co się stanie po wysłaniu.
Deklaratywna wersja WebMCP dodaje opis narzędzia bezpośrednio do formularza:
Lighthouse sprawdza między innymi, czy toolname i tooldescription występują razem, czy wymagane pola mają name oraz czy parametry mają opis albo powiązaną etykietę. Audyt formularzy bez deklaratywnego WebMCP ma obecnie charakter informacyjny. Warunki testowania eksperymentalnego WebMCP zależą od środowiska; lokalny test opisuję poniżej.
W powyższym przykładzie nie ma atrybutu toolautosubmit, więc agent AI może odnaleźć formularz i uzupełnić pola, ale użytkownik nadal ręcznie zatwierdza jego wysłanie. Z kolei dodanie toolautosubmit pozwala wywołaniu narzędzia uruchomić wysłanie formularza automatycznie. Dla wyszukiwarki produktów może to być wygodne, lecz przy płatności, publikacji, rezerwacji albo usunięciu danych taka decyzja wymaga osobnej analizy ryzyka.
Brak toolautosubmit określa zachowanie wywołania narzędzia w deklaratywnym API. Nie jest jednak blokadą automatyzacji zwykłego interfejsu ani zamiennikiem kontroli po stronie aplikacji.
Bezpieczeństwo WebMCP: poprawny schemat to dopiero początek
Pamiętaj, że samo zaliczenie kontroli schematu w Lighthouse nie oznacza, że narzędzie WebMCP jest bezpieczne. Agent działa na treści pochodzącej z wielu źródeł i może zetknąć się z pośrednim prompt injection, czyli instrukcją umieszczoną przez atakującego w stronie, komentarzu, wiadomości albo danych zwróconych przez inne narzędzie. W związku z powyższym nie można przenosić odpowiedzialności za autoryzację na model.
Sprawdzaj sesję, uprawnienia i zakres operacji ponownie po stronie serwera.
Waliduj wszystkie argumenty niezależnie od schematu widocznego dla agenta.
Wymagaj świadomego potwierdzenia przed płatnością, publikacją, wysłaniem wiadomości i usunięciem danych.
Projektuj operacje tak, aby przypadkowe ponowienie żądania nie tworzyło duplikatów.
Nie zwracaj danych osobowych ani sekretów, których agent nie potrzebuje do ukończenia zadania.
Udostępniaj narzędzia zewnętrznym domenom wyłącznie wtedy, gdy są jawnie zaufane.
W imperatywnym API warto oznaczać narzędzia tylko do odczytu przez readOnlyHint, a narzędzia zwracające treść użytkowników lub dane zewnętrzne przez untrustedContentHint. Aktualna dokumentacja bezpieczeństwa WebMCP opisuje też consequentialHint dla działań o istotnych lub nieodwracalnych skutkach. Sprawdź obsługę adnotacji w używanej wersji przeglądarki. Są to wskazówki dla agenta, a nie mechanizmy autoryzacji. Narzędzie zmieniające stan powinno zostawiać ślad audytowy i zwracać jednoznaczny wynik, aby agent nie ponawiał operacji tylko dlatego, że nie zrozumiał odpowiedzi.
Jak przetestować Przeglądanie Agentowe i gotowość strony dla agentów AI?
Aktualnie nie istnieje jeden „AI-ready score”, dlatego najlepiej połączyć ze sobą kilka prostych testów. Sam raport Lighthouse dotyczy konkretnego URL-a oraz stanu interfejsu uchwyconego podczas pomiaru. Nie przechodzi całej witryny i nie dowodzi, że agent ukończy wieloetapowe zadanie.
PageSpeed Insights i Lighthouse. Sprawdź, czy Przeglądanie Agentowe pojawia się w raporcie i które audyty są oznaczone jako zaliczone, oblane albo informacyjne. Lokalnie możesz użyć CLI:
Według dokumentacji kategorii test wymaga Chrome 150 lub nowszego, a audyty WebMCP — udziału witryny w programie testów origin. Osobno, do lokalnego eksperymentowania z narzędziami WebMCP, poradnik Chrome opisuje flagę chrome://flags/#enable-webmcp-testing i Chrome DevTools for Agents. Nie zakładaj, że ustawienia lokalnej przeglądarki obowiązują również w PSI ani że Chrome 150 obsługuje wszystkie późniejsze rozszerzenia API. @latest jest wygodne podczas ręcznego sprawdzania nowych audytów, ale w CI przypnij konkretną wersję Lighthouse. Inaczej aktualizacja narzędzia może zmienić wynik bez żadnej zmiany w kodzie strony.
Wynik może się też zmieniać w sytuacji, kiedy narzędzia WebMCP są rejestrowane dynamicznie i raz zdążą pojawić się przed wykonaniem migawki strony przez Lighthouse, a innym razem już nie. W związku z tym sprawdzaj raport razem z numerem wersji Lighthouse, końcowym URL-em po przekierowaniach i ostrzeżeniami uruchomienia.
Jeśli nie widzisz kategorii lub narzędzi WebMCP, sprawdź wersję i konfigurację używanego produktu, obsługę eksperymentalnego API oraz ostrzeżenia raportu. Brak kontroli, wynik „nie dotyczy” i niezaliczony audyt to różne sytuacje.
CLS w tej kategorii jest pomiarem laboratoryjnym. Lighthouse obserwuje kontrolowane załadowanie strony, więc może nie zarejestrować przesunięć pojawiających się później: po otwarciu menu, zgodzie na cookies, przewinięciu karuzeli albo dłuższej pracy aplikacji. Porównaj go z danymi terenowymi z CrUX lub własnego RUM i osobno przetestuj interaktywne przepływy. Nie każdy ruch interfejsu zwiększa CLS: przesunięcia w ciągu 500 ms od kwalifikującego się wejścia użytkownika mogą być wykluczane z obliczeń. Niski wynik nie zastępuje testu konkretnej interakcji. Ograniczenia pomiaru CLS szerzej opisuje web.dev.
Nie ograniczaj testu do strony głównej, ale wybierz reprezentatywny adres dla każdego ważnego szablonu i sprawdź przynajmniej:
- Stronę główną, artykuł, ofertę lub produkt oraz formularz.
- Widok mobilny i desktopowy.
- Menu, okno modalne, walidację błędnych danych i komunikat powodzenia.
- Stan anonimowy i zalogowany, jeżeli aplikacja je rozróżnia.
- Ścieżkę wymagającą potwierdzenia oraz bezpieczne ponowienie operacji.
Drzewo dostępności. W Chrome DevTools sprawdź nazwy i role najważniejszych elementów, czyli menu, CTA, formularzy, kart usług i przycisków ikonowych. Jeśli użytkownik widzi przycisk, a drzewo dostępności pokazuje pusty element, agent również dostaje słaby sygnał.
Playwright jako szybki test kontrolny semantyki. W CI nie musisz robić testów pod AI, ale możesz testować warunki, których agent potrzebuje:
Przykład zakłada nawigację o nazwie „Główna” i formularz w obszarze main, więc w swoim przypadku dopasuj nazwy do interfejsu, jaki masz w projekcie. Z kolei zawężenie locatorów zapobiega przypadkowym dopasowaniom np. do drugiego linku w stopce. To szybki test kontrolny nazw i widoczności, a szerzej na ich temat mówi dokumentacja Playwright.
Eksploracyjny test z modelem. Może być pożyteczny, by wyłapać niektóre problemy. Wklej agentowi HTML strony albo podaj link i poproś: „Znajdź najważniejszą ofertę, formularz kontaktowy i najnowszy artykuł”. Jeśli model gubi się w nawigacji, myli CTA albo nie potrafi wskazać kluczowej treści, sprawdź strukturę strony. Taki test nie jest jednak powtarzalnym pomiarem porównawczym, ponieważ wynik zależy od modelu, narzędzi i sposobu renderowania.
Test pełnego zadania. Na środowisku testowym zleć agentowi: „Znajdź ofertę audytu, przejdź do kontaktu i przygotuj zapytanie. Zatrzymaj się przed wysłaniem, pokaż dane do zatwierdzenia”. Następnie sprawdź osobno walidację błędnych danych, zatwierdzenie i komunikat sukcesu na kontrolowanym endpointcie. Kryterium ukończenia powinno obejmować poprawne dane, wymagane potwierdzenie i dokładnie jedno zapisane zgłoszenie, także po ponowieniu żądania.
Zapisz model i narzędzie, wersje środowiska, stan początkowy, rezultat oraz interwencje człowieka. Kilka powtórzeń przed i po zmianie pozwoli wychwycić niestabilność, ale nie będzie miarodajnym pomiarem porównawczym wszystkich agentów. Jeśli zadanie zatrzymuje się na logowaniu, CAPTCHA, WAF, banerze zgód lub limicie żądań, odnotuj tę barierę oddzielnie od problemów semantyki. Nie wyłączaj zabezpieczeń dla poprawy wyniku; sprawdź przewidzianą ścieżkę dostępu i przekazania kontroli użytkownikowi.
Logi i pobieranie strony bez JS. Jeśli kluczowa treść znika bez JavaScriptu, porównaj początkowy HTML z wyrenderowanym DOM-em i sprawdź renderowanie w narzędziach indeksowania. To sygnał zależności od JS, ale sam nie dowodzi problemu z indeksowaniem: Google potrafi przetwarzać JavaScript. Prosty klient HTTP, agent korzystający z DOM-u lub drzewa dostępności i agent sterujący na podstawie zrzutów ekranu mają różne możliwości. Test bez JS nie zastępuje testu agenta działającego w pełnej przeglądarce.
Logi serwera jako uzupełnienie GA4. Klasyczna analityka nie pokaże wielu żądań robotów indeksujących, ponieważ GA4 wymaga uruchomienia JavaScriptu. Logi dostępu pozwalają sprawdzić żądania do llms.txt i podstron, ale sam nagłówek User-Agent nie potwierdza tożsamości bota. Jeśli dostawca publikuje metodę weryfikacji lub zakresy adresów IP, zestaw je z logami. Pamiętaj też, że żądanie w logu nie dowodzi wykorzystania ani zacytowania treści.
Dlaczego strona czytelna dla agentów AI daje przewagę biznesową?
Ścieżka zakupowa może zacząć się od zlecenia przekazanego asystentowi, na przykład „znajdź mi wykonawcę szybkiej strony usługowej w Astro albo Next.js, który zna techniczne SEO”. Jest to inny scenariusz niż klasyczne wpisanie kilku słów w wyszukiwarkę. Nie należy jednak wyciągać z samego raportu zapytań w Search Console wniosku, że konkretną frazę wygenerował agent. Dla widoczności w funkcjach generatywnych Google właściwszym źródłem jest osobny raport Generative AI w Search Console. Google poinformował o jego globalnym udostępnieniu 31 sierpnia 2026 r. Nie jest to jednak rejestr wizyt wszystkich agentów ani pomiar cytowań we wszystkich asystentach.
Agent przetwarza dostępny kontekst: treść, strukturę, linki, dane autora, semantykę, dostępność oraz stabilność interfejsu. Opcjonalnie może korzystać także z dodatkowych mechanizmów, takich jak llms.txt lub WebMCP.
Jeśli Twoja strona jest czytelna dla maszyn, zmniejszasz ryzyko, że agent nie zrozumie oferty albo nie znajdzie właściwej podstrony. W ten sposób techniczna czytelność strony staje się częścią dystrybucji. Witryna ma nie tylko wyglądać atrakcyjnie, ale także powinna być łatwa do streszczenia i użycia. Nie jest to jednak gwarancja cytowania przez asystentów AI.
Kontekst jako usługa: przyszłość SEO dla agentów AI
Zamiast optymalizować stronę pod nieznany algorytm AI, tworzyć sztuczne listy kontrolne, składać przesadne obietnice i pisać treści bardziej pod narzędzie niż pod człowieka, lepiej zacząć od przyjęcia innego modelu myślenia o problemie.
Można nazwać ten model kontekstem jako usługą (ang. ), w którym strona dostarcza informacje różnym odbiorcom. Najważniejsi są użytkownicy, którzy chcą szybko zrozumieć ofertę lub produkt. Odbiorcą jest również Twój zespół utrzymujący treść, mapę witryny i dane strukturalne z jednego źródła prawdy. Do tego dochodzi Googlebot indeksujący treść oraz agent AI, który może ją streścić, porównać albo wykonać akcję.
Semantyczny HTML, stabilny layout, dostępna nawigacja i czytelna treść pomagają ludziom, wyszukiwarkom oraz agentom, a SSR lub SSG mogą dodatkowo ograniczyć zależność kluczowej treści od klientowego JavaScriptu. Dodatki takie jak llms.txt i WebMCP pozostają opcjonalnymi warstwami dla konkretnych narzędzi i scenariuszy.
Jeśli chcesz sprawdzić gotowość projektu w React, Next.js albo Astro, obejmującą drzewo dostępności, CLS i renderowanie treści, napisz do mnie. Audyt powinien kończyć się listą konkretnych poprawek w kodzie, a nie ogólną etykietą „AI-ready”.